Por qué Google no indexa mi página, diagnóstico y solución
Publicas, esperas y Google sigue sin mostrar tu página. Te explico cómo diagnosticar cada estado de indexación y qué hacer en cada caso #SEO #SearchConsoleo.
Si te preguntas por qué Google no indexa mi página, la respuesta casi nunca es un fallo aleatorio del buscador. Es una decisión, y esa decisión tiene una causa concreta que puedes identificar en menos de diez minutos con las herramientas adecuadas. El error más común es tratar todos los casos igual y pulsar Solicitar indexación una y otra vez esperando un resultado distinto, cuando el problema real puede estar en el robots.txt, en una etiqueta noindex olvidada, en una canónica mal apuntada o, la causa más frecuente y la más incómoda de aceptar, en la calidad del propio contenido.
En esta guía vas a encontrar el proceso de diagnóstico completo que utilizo en auditorías reales: qué significa exactamente cada estado que muestra Search Console, cuál es la causa técnica detrás de cada mensaje y qué acción concreta resuelve cada situación. Sin rodeos y sin recomendaciones genéricas del tipo mejora tu contenido, porque eso no le dice nada a nadie.
Te aviso de algo antes de empezar, porque marca la diferencia entre perder semanas y resolverlo hoy: rastreo, indexación y posicionamiento son tres fases distintas y cada una falla por motivos diferentes. Google puede rastrear tu página sin indexarla, puede indexarla sin mostrarla en buenas posiciones y puede descubrirla sin llegar a rastrearla nunca.
Confundir estas fases es la razón por la que tanta gente aplica la solución equivocada al problema equivocado. Vamos a separarlas con claridad, vas a aprender a leer los informes de indexación como un diagnóstico médico y al final tendrás una tabla de referencia con todos los estados posibles, su causa y su solución para guardar y consultar cada vez que te encuentres con una URL que no aparece. También incluyo los límites reales de la cuota de solicitud de indexación y cuándo compensa recurrir a la API, dos temas donde circula bastante información equivocada.
Las tres fases que debes distinguir antes de diagnosticar
Google procesa tu página en tres fases consecutivas: descubrimiento, rastreo e indexación. En el descubrimiento encuentra la URL a través de enlaces o del sitemap. En el rastreo descarga el contenido con su robot. En la indexación decide si guarda esa página en su índice y la hace elegible para aparecer en los resultados.
Cada fase puede fallar por su cuenta y el síntoma es distinto en cada caso. Si falla el descubrimiento, Google ni siquiera sabe que tu página existe y no aparecerá en ningún informe. Si falla el rastreo, la URL aparece como detectada pero no rastreada, normalmente por bloqueos o por problemas de servidor. Si falla la indexación, Google ha visto tu contenido y ha decidido no guardarlo, que es el escenario más habitual y el que más trabajo exige.
Hay una cuarta situación que muchos confunden con un problema de indexación y no lo es: la página está indexada pero no aparece en los resultados porque su posición media está en la segunda o tercera página. Ahí el trabajo ya no es técnico sino de relevancia y competitividad. Antes de tocar nada, confirma en cuál de estas cuatro situaciones estás.
Cómo comprobar si Google ha indexado una URL
Para saber si una página está indexada, usa la herramienta de Inspección de URLs de Search Console: pega la dirección completa en la barra superior y espera el resultado. Si aparece el mensaje La URL está en Google, la página está indexada. Cualquier otro mensaje indica un problema que el informe detalla justo debajo.
Existe un atajo rápido que conviene conocer con sus limitaciones: buscar en Google el comando site: seguido de la URL completa. Si aparece el resultado, está indexada. Este método sirve para una comprobación de urgencia, pero no te dice el motivo cuando la respuesta es negativa, así que úsalo solo como primer vistazo.
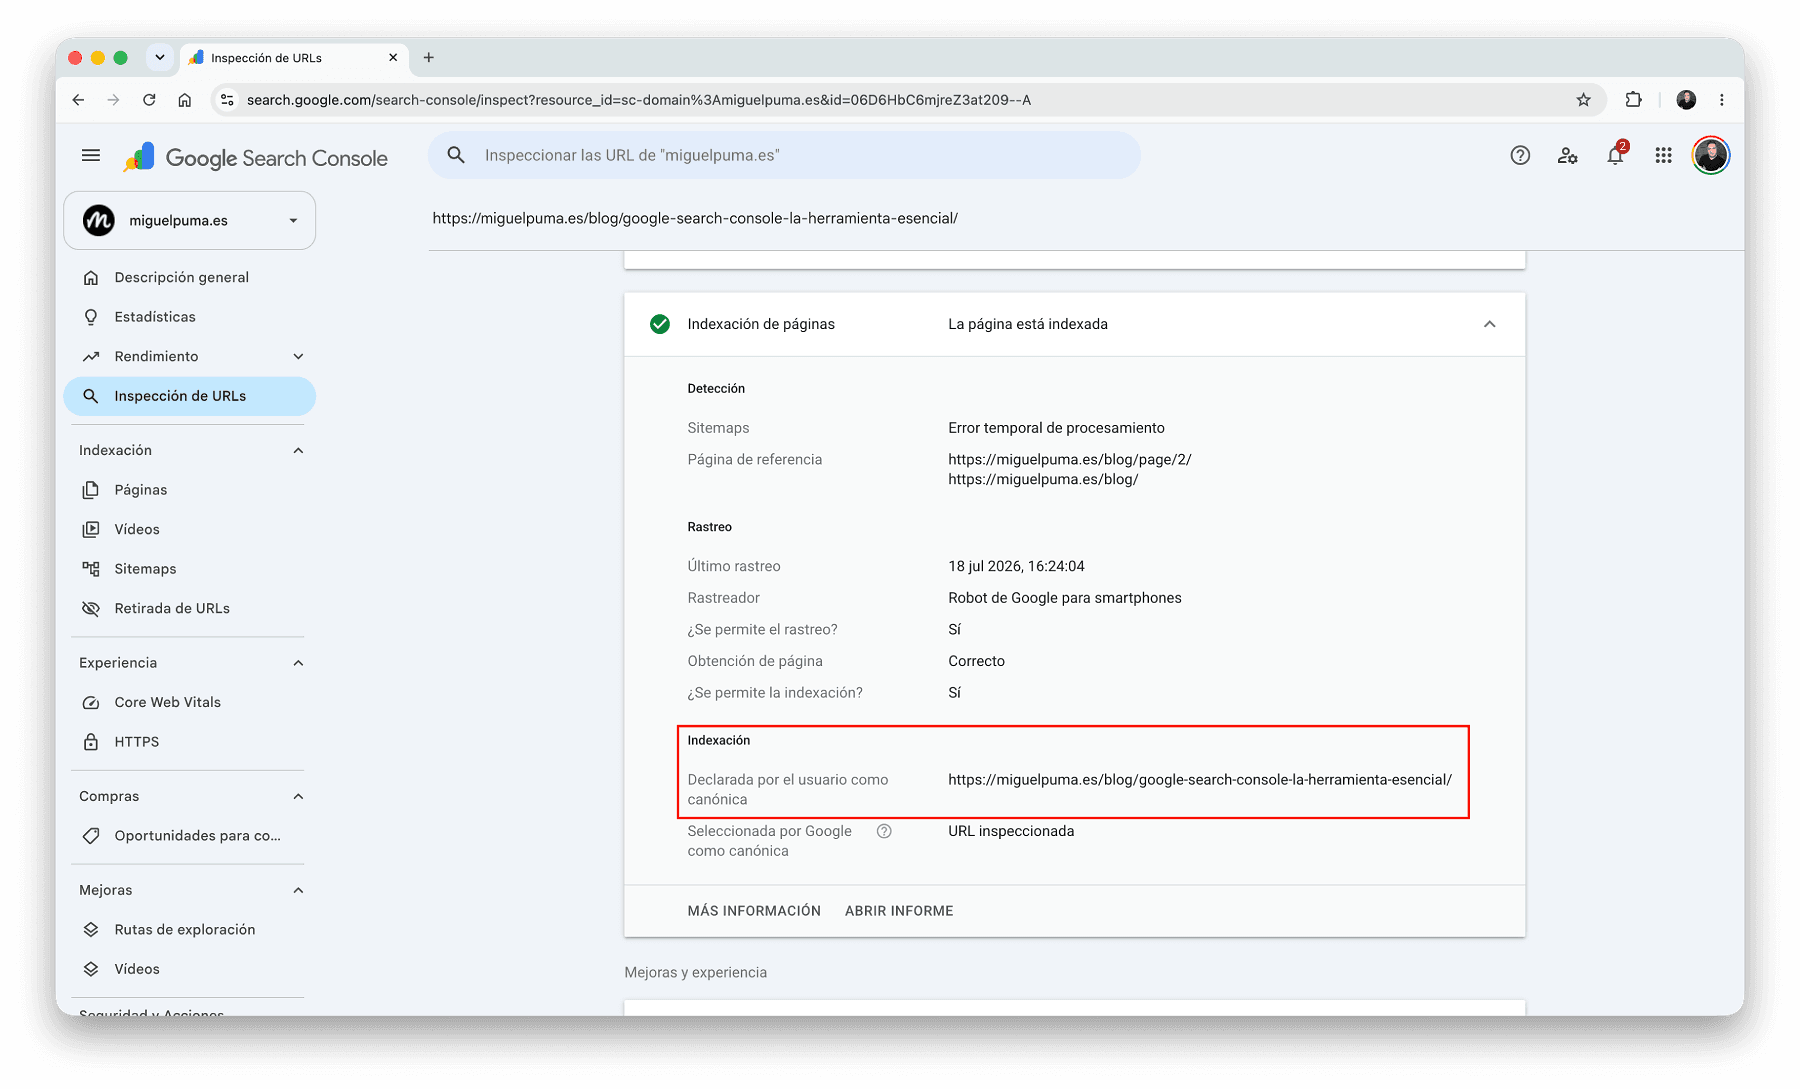
El informe de Inspección de URLs incluye un dato que mucha gente pasa por alto y que resuelve la mitad de los diagnósticos: la sección Indexación, donde ves la canónica que tú declaras y la que Google ha seleccionado. Si no coinciden, Google ha decidido que otra página de tu sitio es la versión principal de ese contenido, y esa es la causa de que la tuya no aparezca.
Los estados de indexación de Search Console y su solución
El informe Páginas de Search Console agrupa las URLs no indexadas por motivo. Cada estado corresponde a una causa técnica distinta y aplicar la solución equivocada no solo no arregla nada, sino que te hace perder semanas. Esta es la tabla de referencia con los estados más frecuentes, según la nomenclatura oficial de Google Search Central.
| Estado | Qué significa | Qué hacer |
|---|---|---|
| Rastreada, actualmente sin indexar | Google la ha visto y ha decidido no incluirla | Mejorar profundidad y utilidad del contenido, reforzar enlazado interno |
| Detectada, actualmente sin indexar | Conoce la URL pero aún no la ha rastreado | Revisar rendimiento del servidor y presupuesto de rastreo, reducir URLs inútiles |
| Página alternativa con etiqueta canónica adecuada | Otra URL es la versión principal | Verificar si la canónica es correcta o si hay contenido duplicado que consolidar |
| Duplicada: Google eligió una canónica distinta | Hay contenido casi idéntico en varias URLs | Consolidar con 301 o diferenciar el contenido de cada página |
| Excluida por la etiqueta noindex | La página lleva una directiva noindex | Retirar la etiqueta si la indexación se desea |
| Bloqueada por robots.txt | El rastreo está prohibido en el archivo | Retirar el bloqueo si la página debe indexarse |
| No encontrada (404) | La URL no existe | Restaurar el contenido o redirigir con 301 si hay equivalente |
| Página con redirección | La URL redirige a otra | Comprobar que el destino es correcto y no encadena redirecciones |
De todos estos estados, el que más quebraderos de cabeza da es Rastreada, actualmente sin indexar, porque no señala ningún error técnico. Es Google diciéndote, sin decirlo, que tu página no aporta lo suficiente como para ocupar espacio en su índice. Y esa es la razón por la que el siguiente apartado es el más importante de la guía.
Rastreada actualmente sin indexar, la causa más frecuente y la más incómoda
El estado rastreada actualmente sin indexar significa que Google descargó tu página, la evaluó y decidió que no merecía entrar en el índice. No hay bloqueo técnico ni error de servidor. Es un juicio de valor sobre la utilidad del contenido, y la solución pasa por reescribir, no por insistir con la solicitud de indexación.
Los patrones que se repiten en las páginas afectadas son bastante reconocibles. Contenido que describe un tema en lugar de resolverlo, lleno de expresiones como es importante revisar o se recomienda optimizar sin explicar cómo. Textos que duplican, sin aportar nada nuevo, lo que ya dicen mejor otras páginas del propio sitio. Artículos huérfanos a los que no apunta ningún enlace interno relevante. Y páginas creadas para cubrir una keyword más que para responder a una persona.
Te lo cuento con un caso propio de mi web donde llevo años documentando auditorías técnicas con datos de Search Console, porque prefiero enseñar la cicatriz que la teoría. Esta misma URL que estás leyendo estuvo en ese estado durante meses.
DATO: Esta URL, acumulaba 481 impresiones y 0 clics con una posición media de 19,78, es decir, Google la mostraba ocasionalmente en segunda página pero nadie llegaba a ella.
La reescritura consistió en tres movimientos: sustituir las recomendaciones vagas por procesos accionables con capturas reales, añadir la tabla de estados que acabas de leer y separar temáticamente esta guía de otro artículo del blog que trataba lo mismo desde otro ángulo.
DATO: Quince días después de publicar los cambios, la URL pasó a estado indexada y su posición media subió de 19,78 a 3,4.
La lección que me llevo, y que aplico desde entonces en cada auditoría, es que la indexación no se pide, se merece. Cuando Google rastrea una página y decide no indexarla, ninguna herramienta va a cambiar esa decisión: solo la va a cambiar un contenido que resuelva la consulta mejor que las páginas que ya ocupan el índice.
Cuántas veces puedes solicitar indexación y cuándo sirve de algo
La herramienta Solicitar indexación de Search Console tiene una cuota diaria limitada por propiedad, en torno a una docena de URLs al día, y no garantiza la indexación: solo coloca tu página en la cola de rastreo con prioridad. Pulsarla varias veces sobre la misma URL no acelera nada y consume cuota que podrías usar en otras páginas.
La solicitud tiene sentido en dos situaciones. Cuando publicas contenido nuevo que quieres que Google vea cuanto antes, y cuando has corregido un problema real y necesitas que vuelva a evaluar la página. En cualquier otro caso estás pidiendo a Google que reconsidere una decisión sin haberle dado ningún motivo nuevo para cambiarla, y la respuesta será la misma.
Hay tres aceleradores que funcionan mejor que la solicitud manual. El sitemap actualizado y sin errores, porque es el canal por el que Google espera enterarse de tus novedades. El enlazado interno desde páginas que ya reciben rastreo frecuente, que transmite relevancia además de descubrimiento. Y la frecuencia de publicación, porque un sitio que se actualiza recibe visitas del robot más a menudo.
Cuándo usar la API de indexación de Google
La API de indexación de Google está diseñada oficialmente para dos tipos de contenido: ofertas de empleo y vídeos en directo, según la documentación de Google Search Central. Permite notificar altas y bajas de URLs de forma programática con cuotas mucho más altas que la herramienta manual, pero fuera de esos dos casos Google no garantiza que procese las peticiones.
Existe un uso extendido de la API para contenido general y funciona en muchos sitios, pero conviene saber que se está operando fuera de la documentación oficial y que Google puede dejar de atender esas llamadas sin previo aviso. Si decides probarlo, hazlo como complemento y nunca como sustituto de un sitemap bien mantenido.
Para la mayoría de proyectos, incluido un blog profesional, la combinación de sitemap correcto, enlazado interno sólido y contenido que merezca indexarse rinde más que cualquier atajo técnico. La API resuelve un problema de volumen y urgencia, no un problema de calidad.
Checklist de diagnóstico rápido cuando una página no aparece
Guarda esta secuencia y aplícala en orden, porque cada paso descarta una causa y evita que pierdas tiempo en la siguiente.
- Inspecciona la URL en Search Console y anota el estado exacto.
- Comprueba si el rastreo está permitido y si la indexación está permitida en ese mismo informe.
- Revisa la canónica declarada frente a la seleccionada por Google.
- Verifica que la URL está incluida en el sitemap y que el sitemap se procesa sin errores.
- Comprueba que la página recibe al menos un enlace interno desde una sección relevante del sitio.
- Busca contenido similar en tu propio dominio que pueda estar compitiendo por la misma intención.
- Y solo si todo lo anterior está correcto, asume que el problema es de calidad y reescribe con el foco puesto en resolver la consulta mejor que las páginas que ahora ocupan el top.
- Publica, actualiza la fecha de modificación y entonces sí, solicita la indexación una única vez. Nueve, revisa el estado a los quince días.
Errores que retrasan la indexación sin que te des cuenta
El error más caro es solicitar indexación de forma repetida sin haber cambiado nada en la página, porque consume cuota y no aporta a Google ninguna razón nueva para reconsiderar su decisión. Le siguen bloquear por robots.txt páginas que llevan noindex y publicar contenido sin ningún enlace interno que lo respalde.
El caso del robots.txt merece una explicación, porque es contraintuitivo. Si bloqueas el rastreo de una página que lleva noindex, Google no puede leer esa etiqueta y la URL puede quedarse indexada de forma indefinida con el mensaje indexada aunque bloqueada por robots.txt. Para desindexar hay que permitir el rastreo, no impedirlo.
Completa la lista de errores frecuentes: sitemaps con URLs que devuelven errores o redirecciones, canónicas que apuntan a páginas distintas de las que deberían, contenido principal que depende de JavaScript para renderizarse y páginas huérfanas creadas para el buscador y no para el usuario, que son justo las que Google descarta primero.
Sobre esta guía
Esta guía la firma Miguel Puma, especialista en SEO técnico y analítica digital con más de 20 años de experiencia en marketing digital. El método de diagnóstico que acabas de leer es el que aplico en auditorías reales de indexación, apoyado en datos de Google Search Console y en la documentación oficial de Google Search Central.
Actualizada por última vez en julio de 2026. Los criterios de indexación de Google cambian con cada actualización del núcleo, así que reviso y actualizo esta guía de forma periódica. Si detectas algún estado que no aparece en la tabla, déjamelo en los comentarios y lo incorporo.
Preguntas frecuentes sobre indexación en Google
Lo más habitual es que aún no la haya rastreado, sobre todo en sitios con poca frecuencia de publicación. Comprueba en Search Console si aparece como Detectada actualmente sin indexar, verifica que está en el sitemap y que recibe algún enlace interno. Si el estado es Rastreada actualmente sin indexar, el problema ya no es de descubrimiento sino de calidad del contenido.
Puede tardar desde unas horas hasta varias semanas, según la autoridad del dominio, la frecuencia de rastreo y la fuerza del enlazado interno. En sitios que publican con regularidad la indexación suele producirse en pocos días. Si tras un mes la página sigue sin indexarse pese a estar rastreada, la causa casi siempre es la calidad y no el tiempo.
Significa que Google ha descargado y evaluado la página, pero ha decidido no incluirla en su índice. No hay error técnico: es una valoración sobre la utilidad del contenido. La solución pasa por mejorar la profundidad y la originalidad del texto, reforzar el enlazado interno y eliminar el solapamiento con otras páginas del mismo sitio.
No. Solicitar indexación solo influye en que Google rastree antes la página, no en la posición que ocupará después. Una URL puede indexarse rápidamente y quedarse en segunda página durante meses si su contenido no compite. Indexación y posicionamiento son fases distintas y responden a criterios diferentes.
La cuota diaria de solicitudes de indexación ronda la docena de URLs por propiedad y se restablece cada día. Es un límite pensado para altas puntuales, no para procesar sitios enteros. Para volúmenes altos, la vía correcta es un sitemap XML actualizado que Google consulta de forma automática y periódica.
Sí. Google revisa continuamente su índice y puede retirar páginas que han perdido relevancia, que han quedado obsoletas o que duplican contenido de otras URLs. También ocurre tras cambios técnicos como una etiqueta noindex añadida por error, una canónica mal configurada o un bloqueo nuevo en el robots.txt.